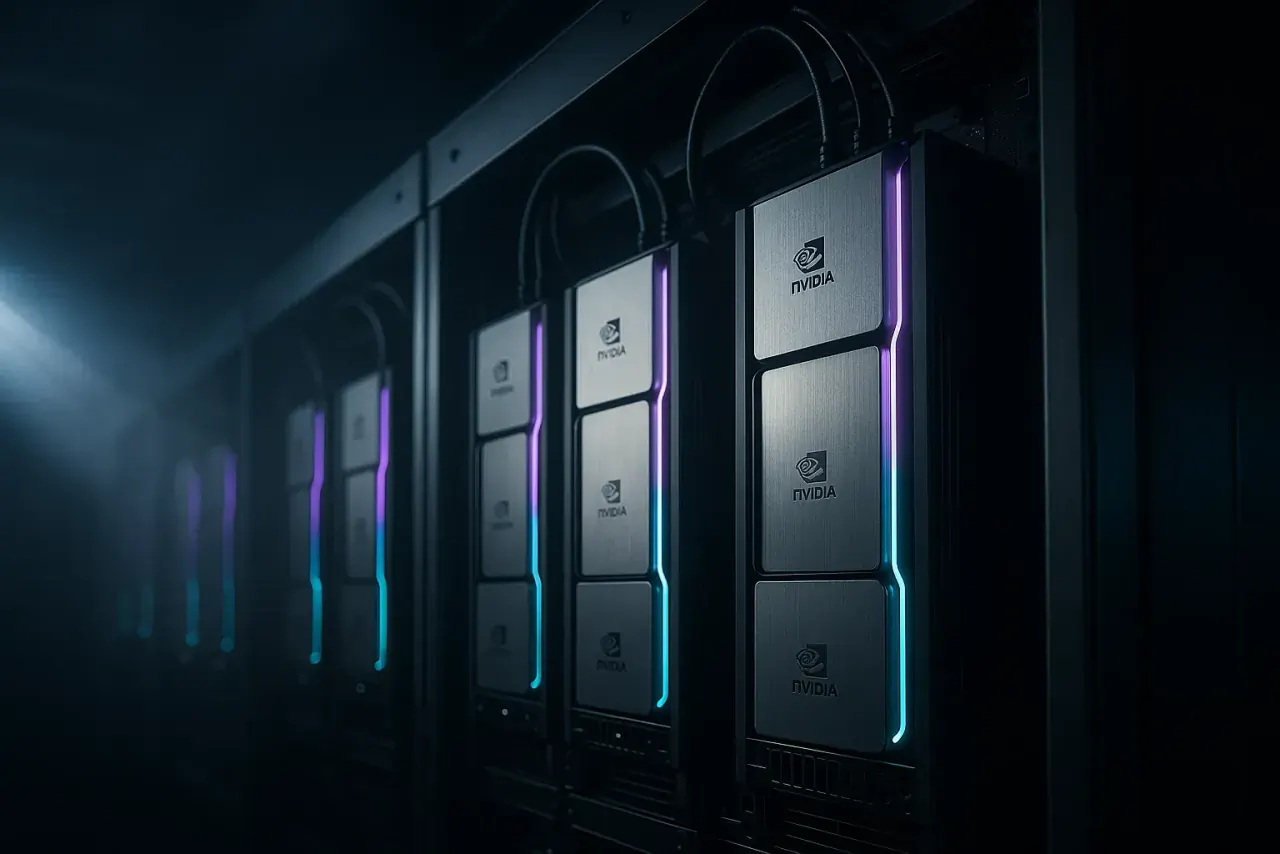
Профессиональная GPU-ускоритель NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GDDR7 для AI inference, рендеринга и production-нагрузок. Архитектура Blackwell, 4-е поколение RT Cores.
Характеристики NVIDIA RTX PRO 6000
Полная техническая спецификация GPU-ускорителя NVIDIA RTX PRO 6000. Под конкретный сервер форм-фактор и охлаждение подбираем индивидуально.
NVIDIA RTX PRO 6000
- Архитектура: Blackwell (RTX PRO)
- CUDA Cores: 24 064
- Tensor Cores: 5-е поколение, FP4/FP6/FP8
- Память: 96 GB GDDR7 ECC, 1.6 TB/s
- FP8 / низкая точность: 4 000 TFLOPS (FP4: 8 PFLOPS)
- FP16 / BF16: 2 000 TFLOPS
- FP64: 50 TFLOPS
- TDP: 600 Вт (Server Edition: 300 Вт max-Q)
Интерфейсы
- NVLink: 1.8 TB/s (NVLink 5.0)
- Форм-фактор: PCIe 2-slot или max-Q passive
- PCIe: Gen5 x16 (поддержка Gen4)
- Multi-Instance GPU: до 7 разделов на GPU
- Виртуализация: NVIDIA vGPU, MIG, SR-IOV
- Безопасность: Confidential Computing
Серверы под NVIDIA RTX PRO 6000
- Dell: PowerEdge XE9680, XE8640, R760xa
- HPE: ProLiant XD685, DL380a, Cray EX254n
- Supermicro: AS-8125GS, SYS-821GE, SYS-421GE
- Lenovo: ThinkSystem SR675 V3, SR680a V3
- : NF5688M6, NF5468M6
- : FusionServer G5500 V5
- Cisco: UCS C480 ML, C240 M7
Что включено
- CUDA Toolkit: 12.4+ с cuDNN, NCCL, TensorRT
- Драйверы NVIDIA: Data Center Driver R550+
- Контейнеризация: Docker, NVIDIA Container Toolkit
- ML фреймворки: PyTorch 2.x, TensorFlow, JAX, vLLM
- Тесты при поставке: CUDA-Z, NVIDIA-SMI, MLPerf
- Стресс-тест:
- Гарантия:
GPU-ускорители для сервера
Профессиональные GPU-ускорители NVIDIA для AI, инференса, рендеринга и научных вычислений. Сравните объём VRAM, bandwidth, TFLOPS и подберите GPU под вашу задачу.
Как мы работаем над проектом
Проектирование системы начинается с задачи, а не с перечня доступного оборудования. Заказчик не обязан заранее знать, какой именно GPU, процессор, объём памяти или тип сети ему нужен - это работа технического подбора.
Вы описываете задачу или присылаете готовое техническое задание. Что планируется считать: обучение или дообучение модели, инференс, генеративные модели, RAG, компьютерное зрение, инженерные расчёты. Какой объём данных, какой режим работы, есть ли ограничения по размещению оборудования.
Разбираем профиль нагрузки и определяем архитектуру: требуется ли один узел или многоузловая система, какой класс GPU и сколько памяти GPU нужно под задачу, какая роль отводится процессору и системной памяти, как устроена топология PCIe и межGPU-соединение.
Под выбранную архитектуру подбирается серверная платформа и её наполнение: GPU, процессоры, оперативная память, подсистема хранения и сетевая часть. Отдельно учитываются требования платформы к электропитанию и охлаждению.
Формируется итоговая конфигурация и коммерческое предложение. Далее - комплектация, сборка, тестирование и поставка оборудования. Условия и срок гарантии определяются производителем, конфигурацией оборудования и условиями конкретной поставки; срок поставки указывается в коммерческом предложении.
Когда нужна NVIDIA RTX PRO 6000
AI inference больших LLM
96GB GDDR7 - больше чем у H100 80GB. Llama 3 70B FP8 на одной карте, длинные контексты до 128K токенов.
Generative AI и render
SDXL, FLUX, video gen, 3D rendering. RT Cores 4-го поколения - real-time path tracing для архитектуры и кино.
Workstation и edge
Версия Server Edition подходит в стандартные серверы 2U/4U. Низкое TDP в max-Q режиме для edge-deploy.
Что мы поставляем под ключ
NVIDIA RTX PRO 6000 - не просто GPU-ускоритель, а компонент платформы. Мы собираем сервер целиком: подбираем CPU, RAM, NVMe-хранилище и сеть под конкретную задачу клиента. Каждый заказ начинается с интервью на 30-40 минут, где обсуждаем модель, объёмы данных, требования к latency и доступности.
После согласования спецификации выполняется комплектация и сборка системы. Только после успешного прохождения теста сервер отгружается клиенту. Условия и срок гарантии определяются производителем, конфигурацией оборудования и условиями конкретной поставки.
Большинство клиентов возвращаются за расширением кластера - значит, делаем правильно.» Технический директор GPUServer Kazakhstan
Кластеризация и масштабирование
Один узел даёт ограниченный объём compute и памяти. Если задача требует больше - собираем кластер из 2-64 узлов на InfiniBand NDR 400Gb с топологией fat-tree. Типичный проект на 32 узла реализуется за 4-6 недель: согласование спецификации, заказ компонентов, сборка, монтаж в дата-центре клиента, пуско-наладка с MLPerf-бенчмарками.
- До 8 GPU: один сервер, NVLink fabric внутри узла
- 8-16 GPU (2 узла): InfiniBand NDR между узлами, NCCL автоматический выбор топологии
- 16-256 GPU (2-32 узла): fat-tree InfiniBand с неблокирующим коммутатором
- 256+ GPU: dual-rail InfiniBand, проектирование под конкретный workload и помещение клиента
Цена и условия
Итоговая стоимость зависит от формфактора (SXM/PCIe), объёма заказа и текущих курсов USD/KZT. Базовая цена Цена по запросу за карту. Для серверов с 4-8 GPU действуют пакетные условия: скидка на интеграцию, бесплатный стресс-тест и расширенная гарантия. Доставка по Казахстану и странам Центральной Азии - входит в стоимость для заказов от.
Частые вопросы по NVIDIA RTX PRO 6000
Чем NVIDIA RTX PRO 6000 отличается от H100 80GB на практике+
Сколько VRAM нужно для обучения LLM+
SXM или PCIe форм-фактор+
Можно ли масштабировать до кластера+
Какое охлаждение нужно+
Сроки поставки+
Обсудить проект
Расскажите о задаче - инженер подготовит оптимальную конфигурацию и расчёт окупаемости
Получить предложение
Заполните форму - мы свяжемся с вами